会员
 下载APP

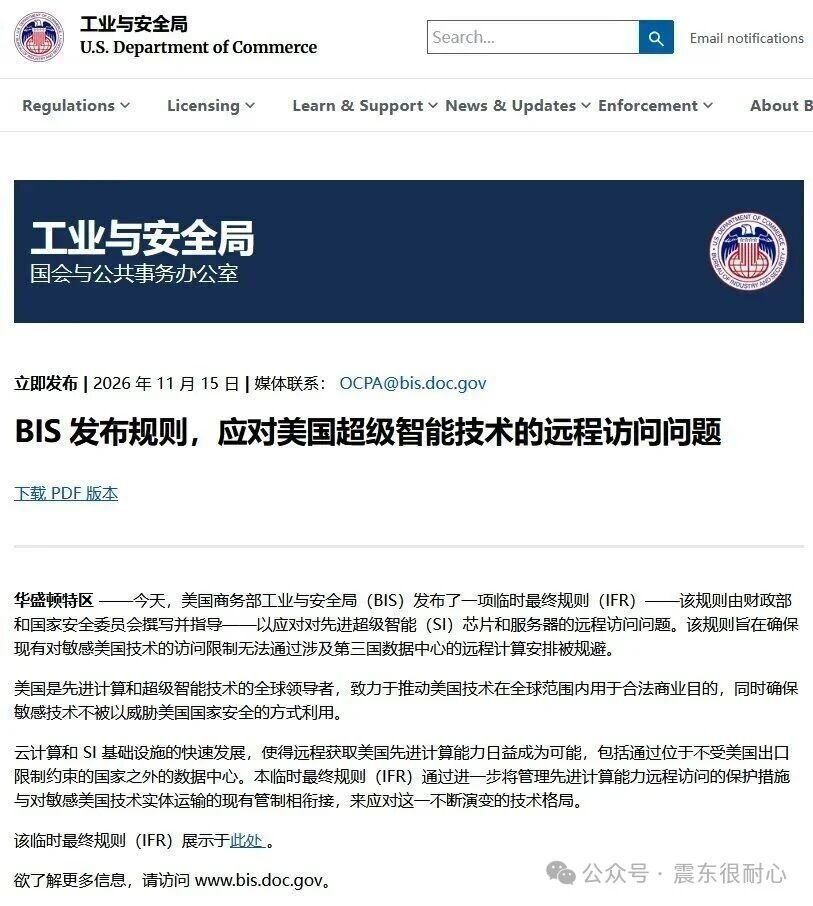
11月16日美国商务部BIS发布的《管控对先进半导体的远程访问》新规,核心主要有四部分:限制全球数据中心向中企提供大量算力(单个数据中心TPP超1200万即触发许可,约相当于750张H200,对万卡级训练集群来说确实杯水车薪)、限制先进芯片出口至东南亚四国和巴西、收紧芯片代工与封测环节的合规推定、废除拜登时期的AI扩散规则。已在对华供货的数据中心有90天过渡期申请许可,新规约在2027年2月中旬生效。
如果真正的严格执行,对于"讯飞星火"之外的国产大模型来说,赖以生存的海外租英伟达算力这条路也被实质性掐断了。
根据我对大模型行业的长期跟踪,个人有个判断:假如美方严格执行规定,对于绝大多数国模来说,现在储备的算力,最多也就支撑到明年上半年。如果届时没有新的政策变化或者他们又能找到漏洞的前提下,大家都必须要用国产算力,别无他法。
那么问题来了,我们国产算力能不能扛得住,给予需求和行业发展的支撑?这块非常敏感,且互联网上极度乐观和理性悲观的论调都存在,我只能以公开数据为准(在此提前声明下)。
华为昇腾950具体性能如何,是不是如同宣传的那么好,我们先不去论它,主要是产能问题才是核心。因为具体技术可以追,产能是物理事实。目前的核心约束非常集中:
1.产线比较缺。 中芯N+2(等效7nm)是全国唯一能规模量产AI芯片的先进制程产线,华为、寒武纪、海光、摩尔线程、平头哥全在门口排队,华为一家锁定约43%的产能(还要覆盖麒麟SoC和基站芯片)。
2.良率还有待提高。 第三方(TechInsights、SemiAnalysis)估算N+2/N+3良率仅20%–40%,远低于台积电同代的80%以上,意味着同样一片晶圆可售芯片只有台积电的三分之一到一半。昇腾910C的2026年产量目标约30万颗,良率拖累下实际交付可能只有目标的六成左右。
3.总量缺口。 2026年底N+2目标月产能7万片,折算AI芯片全年约260万颗,而国内需求约420万颗——每两颗需求就有一颗造不出来。
4.没有EUV,靠DUV多重曝光硬撑。 N+3仍是FinFET+DUV,5nm要靠三次甚至四次曝光,工艺步骤再增三分之一,良率挑战更大;而且扩产还受限于浸没式DUV光刻机的存量和维护能力。
再次声明,以上数据皆为公开信息引用,非私下调研所得。且时效性也应该注意,不是截至到今日的数据。
那我们再递进一步,既然有这几个问题,那么产能大概什么时候可以解决呢?
我说一个我个人的判断,不一定准确,仅供参考。
2027年会持续紧缺。因为需求被政策逼着转向国产,但产能在爬坡,缺口仍然很大。应该会用"排队+配额+优先级"的模式解决当务之急。优先大厂,中小芯片公司流片排期可能推迟。因此大概率明年年中会出现一些芯片荒和涨价现象。中芯国际2026–2028年800亿元先进制程投入、中芯南方SN1扩产和国产设备验证导入,预计2028年会出现缓解。
但需要说明的是"缓解"不是"解决"。因为只要没有EUV,DUV多重曝光的产能扩张速度就天然慢,成本也高一倍以上。
当然,回到国模的发展上,也有一些因素让"产能问题"没有数字上的那么绝望:
1.推理先于训练爆发,而推理对产能不敏感。 训练要万卡级同构集群,推理理百卡级即可、集群间互联要求也低。推理芯片还可以走成熟制程、SRAM/存算一体等多元路线分流先进制程压力,2026年上半年14nm国产GPU服务器出货占比已达45%。
2.需求侧在被算法效率对冲。 国产模型"用更少算力训出更强模型"的路线(蒸馏、稀疏化、MoE)本质上就是因为存在算力缺口的努力和探索。
3.生态迁移的坎在缩小。 CANN已全面开源,兼容性约95%,昇腾生态支持43个大模型预训练、200+开源模型适配。之前国产大模型(讯飞星火除外)都只用国产算力做推理,现在被逼着用训练,对于软件生态是最快能补上的短板。
最后总结一下:
产能大约在2027年下半年或者年底出现实质缓解,2028年有望达到紧平衡;但"彻底解决"(即先进制程产能和良率都不构成瓶颈)取决于EUV/国产光刻的破局,这个时间表没有任何可靠估算,可能以年为单位往后推。
真正的风险不是绝对产能,而是2027甚至2028年的这两年缺口最大的时候,需求端的爆发速度会不会超过芯片爬坡速度?说到这里顺便提一嘴:这可能也是为什么寒武纪股权激励敢定2027年营收翻倍、2028年再翻倍的计划,可能国产半导体产业人赌的就是这个时间表。(不是推荐寒武纪这个股票,特别声明!!!)
备注:以上皆为个人观点,不代表任何投资决策建议和依据。